私たちは、現代のデータ処理において不可欠な技術について探求しています。特に多数のサーバで構成された大規模な分散ファイルシステム機能を提供し、MapReduceによる大規模データの分散処理を実現するOSSは、どのようなものがあるのでしょうか?データの爆発的な増加に伴い、効率的なデータ処理が求められています。
大規模な分散ファイルシステムの概要
大規模な分散ファイルシステムは、効率的なデータ管理とフレキシブルなアクセスを提供するために設計されています。これらのシステムは、複数のサーバー間でデータを分散させ、ユーザーはどこからでもアクセスできるようにします。
分散ファイルシステムとは
分散ファイルシステムは、複数の物理的サーバー群が連携してファイルの保存と管理を行うシステムです。具体的な機能には以下があります:
- データの冗長性を提供し、サーバーの故障に備える
- 大量のデータを効率よく格納するためのデータ分割
- 高速なデータアクセスを実現するためのキャッシュ機能
これにより、ユーザーは大規模データに対してシームレスな操作を行えます。
大規模システムのメリット
大規模分散ファイルシステムを利用することで得られるメリットは多岐にわたります。主なメリットには以下が含まれます:
- スケーラビリティ:必要に応じてサーバーを追加し、システムを拡張できる
- 耐障害性:一部のサーバーがダウンしても、システム全体は機能し続ける
- データ処理の効率化:MapReduceなどの技術と組み合わせることで、大量のデータを迅速に処理できる
MapReduceの基本概念
MapReduceは、大量のデータを効率的に処理するためのプログラミングモデルです。このアプローチは、データの処理を複数のノードに分散させることで、それぞれのノードが独立に作業を行うことを可能にします。こうすることで、大規模なデータセットでも高速に処理することができます。
MapReduceの仕組み
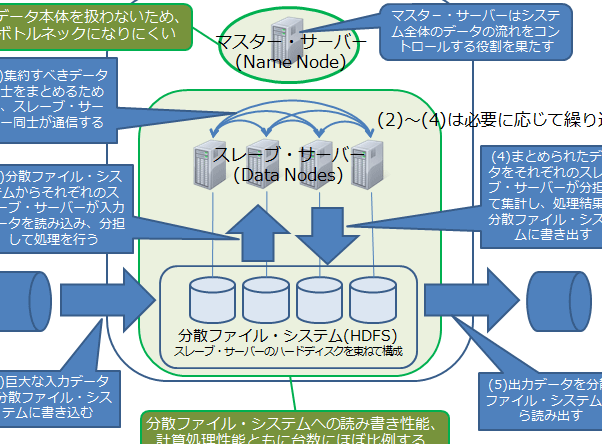
MapReduceの仕組みは、主に二つのフェーズ、つまりMapフェーズとReduceフェーズから成り立っています。具体的には、以下のように進行します。
- Mapフェーズ: データを分割し、各ノードで並行して処理を行う。この際、入力データはキーと値のペアに変換され、各マップタスクが独立して処理します。
- Shuffleステージ: 各マップタスクの出力を集約し、適切なReduceタスクに振り分ける。この過程では、出力が再構成され、同じキーの値がまとめられます。
- Reduceフェーズ: Shuffleで振り分けたデータを集約し、最終的な結果を算出する。ここで、Reduced checkに基づいて結果が生成されていきます。
この構造により、データの並列処理が可能となり、効率的な結果を得られます。私たちが利用する際、必要なデータ量が増大する一方で、処理速度も向上するため、非常に価値のある手法です。
分散処理の利点
分散処理には、いくつかの明確な利点があります。主な利点は以下の通りです。
- スケーラビリティ: ノードを追加することで、処理能力を簡単に拡張できる。システムが成長しても、容易に対応可能。
- 耐障害性: 一部のノードが故障しても、他のノードが機能し続けるため、システム全体の信頼性が向上する。
- コスト効率: 大規模なデータを低コストで処理できる。コモディティハードウェアを使用することで、全体のコストを削減できる。
- 高速なデータ処理: データが分散され、並行処理が行えるため、処理時間が大幅に短縮される。
OSSの選定基準
大規模な分散ファイルシステムを選定する際の基準は複数の要素を考慮する必要があります。特に、スケーラビリティやパフォーマンス、コミュニティのサポートが重要です。
スケーラビリティ
スケーラビリティは、システムが増加するデータ量やユーザー数に対応できる能力を指します。適切なOSSは、短期間で容量を拡張可能です。例えば、以下の特徴を持つOSSが理想的です。
- ノードの追加が容易。
- 水平スケーリングがサポートされている。
- 負荷分散の機能を効率的に活用できる。
これにより、ビジネスやプロジェクトの成長に合わせてシステムを柔軟に拡大できます。
パフォーマンス
パフォーマンスの向上は、データ処理の効率を左右します。特に、以下のポイントが重要です。
- 処理速度が迅速であること。
- データアクセスが低遅延であること。
- リソース管理が最適であること。
これらの要素が揃っているOSSは、私たちが行う大規模データ処理をよりスムーズに実行できる環境を提供します。
コミュニティのサポート
活発なコミュニティサポートは、OSSの選定において欠かせない要素です。具体的には、以下の点が重要です。
- ドキュメンテーションが充実している。
- フォーラムやQ&Aサイトが活発である。
- ユーザー同士の交流が促進されている。
代表的なOSSの紹介
大規模な分散ファイルシステムやMapReduceによる大規模データ処理を実現するOSSには、いくつかの注目すべきプロジェクトがあります。それぞれ独自の機能と特性を持ち、ビッグデータの処理を効率化しています。
Hadoop
Hadoopは、分散ファイルシステムHDFS(Hadoop Distributed File System)とMapReduceフレームワークを基盤としています。Hadoopは以下の特徴を持っています。
- スケーラブル: 数千台のサーバーに簡単にスケールアウトでき、データ量の増加に対応。
- 耐障害性: 自動的にデータの冗長性を管理し、ノードの故障に強いシステム設計。
- コミュニティサポート: 豊富なドキュメントと活発なユーザフォーラムが存在。
これにより、Hadoopは多くの企業で採用され、ビッグデータの解析において優れたパフォーマンスを発揮します。
Apache Spark
Apache Sparkは、Hadoopに比べて大幅に高速なデータ処理を提供します。以下にSparkの特長を示します。
- インメモリ処理: データをメモリに保持することで、ディスクIOを削減し処理速度を向上。
- 多様なAPI: スカラ、Java、Python、Rなど、複数のプログラミング言語に対応。
- ストリーミング処理: リアルタイムデータ処理が可能で、即時の結果を得ることができる。
Sparkは、リアルタイム分析や機械学習に非常に適しています。
Ceph
Cephは、分散ストレージを目的としたOSSであり、オブジェクトストレージシステムを提供しています。Cephの特徴は以下の通りです。
- 統合ストレージ: ブロック、オブジェクト、ファイルシステムのストレージを統合。
- スケーラビリティ: ノードを追加することで、容易にストレージ容量を増加させることができる。
- 自己修復機能: ノード障害時に自動でデータを再配置し、システムの健全性を維持。
まとめと今後の展望
大規模分散ファイルシステムとMapReduceは、データ処理の重要な要素です。これらの技術は、ビッグデータの効率的な管理と処理を可能にし、多くの企業にとって不可欠な存在になっています。効率的なデータ処理の手法を取り入れることで、ビジネスの成長が促進され、競争優位が確保されます。
私たちは、OSSの選択肢が拡大していることに注目しています。多様な機能を持つHadoop、Apache Spark、Cephなどの選択肢が存在し、それぞれ異なるニーズに対処する能力を持っています。私たちの目的は、これらのシステムの特性を理解し、最適なソリューションを選うことです。
今後の展望として、私たは技術の進化により、分散処理の効率性やスケーラビリティがさらに向上すると考えています。特に、AIや機械学習の技術が統合されることで、データの解析や処理が加速するでしょう。私たちが留意すべき点は、セキュリティやプライバシーの確保です。
Conclusion
大規模分散ファイルシステムとMapReduceは、ビッグデータ時代におけるデータ処理の基盤です。私たちはこれらの技術を活用することで、効率的なデータ管理と迅速な処理が可能になります。HadoopやApache Spark、Cephといったオープンソースソフトウェアは、それぞれ異なる特性を持ちながらも、共通してスケーラビリティや耐障害性を提供します。
今後の技術革新により、これらのシステムがさらに進化し、私たちのデータ処理のニーズに応えてくれることが期待されます。AIや機械学習の統合が進む中で、より高度なデータ解析が実現するでしょう。私たちはこれらの変化に注目し、適切なOSSを選択することで、未来に向けたデータ戦略を構築していきます。